体育视频分析长期有一个默认的第一步:先把人找出来。检测运动员,标出关键点,跟踪身份。这一步做得越来越好,好到几乎成了基础设施。近期公开的研究却在不同方向上指向同一个问题:人找到了,然后呢?击球点在哪,球拍拍面朝向何方,杆头在下杆里走了什么路径,这些答案都在“人”之外,在人与器材的接触里。本文是od体育的一次观察,整理近期公开工作里能看到的趋势,措辞尽量克制,凡是未能核实的细节都不写。
观察一:球拍开始被当作一个有姿态的对象
公开资料显示,2025年底出现了一个覆盖乒乓球、网球和羽毛球的数据集,名为RacketVision,随后被AAAI 2026接收。它的特点是在传统的球位置标注之外,加入了球拍姿态的细粒度标注,并围绕三件事设计任务:球的追踪、球拍姿态估计,以及球的轨迹预测。论文里一个耐人寻味的结论是:直接把球拍姿态特征与球的特征拼接在一起,模型效果反而下降;使用交叉注意力这样的融合机制,才能让球拍信息真正发挥作用,并在轨迹预测上超过只用球信息的强基线。
这条结论对工程有一个朴素的提醒:给模型多喂一路信号,并不自动等于更准。“人+球+拍”不是把三份数据放在一起,而是要让模型学会在什么时刻应该看哪一路。这也解释了为什么在《Pose模型看身体,目标检测看球:od体育为什么不能只靠一个AI模型分析体育》里,od体育强调分层、协作,而不是把所有输入一股脑塞进一个网络。
观察二:基准测试开始检验“空间理解”,而不只是“认出动作”
另一条线来自视觉语言模型。公开资料显示,2026年3月出现了一个面向网球、羽毛球和乒乓球的空间智能基准CourtSI-Bench,包含3686组经过验证的问答,内容涉及数量、距离、位置和空间关系,并以球场几何作为度量基准。研究者评估了25个闭源与开源模型,结论是模型与人类之间仍有差距,通用空间智能基准上的表现也难以直接迁移;在其构建的大规模数据上微调一个80亿参数的模型,在该基准上提升了23.5个百分点,并能迁移到未见过的项目。
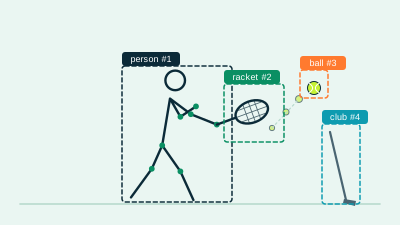
这里需要小心解读。这份结果说明的是“在特定基准里,微调有明显收益”,并不意味着模型已经理解球场。但它提示了一个方向:球场线、网、地面等几何信息,是把“人与器材”放进真实尺度里的锚点。没有这个锚点,“击球点在身体前方”只是画面上的相对位置,无法变成厘米。相关的追踪问题,在《体育大模型到底需要认识多少种“物体”?od体育AI同时追踪人、篮球、网球、球拍和球杆》中有更具体的讨论。
观察三:多模态大模型在细粒度、高速动作上仍然吃力
几项面向体育的评测给出了相近的信号。公开资料显示,FineBadminton把羽毛球视频分成基础动作、战术语义和决策评估三个层次标注,并指出当前多模态大语言模型在深入的体育视频分析上仍面临明显困难,同时提出以击球为中心的关键帧选择等方法带来改善。SportR则把视觉感知与规则推理结合,包含近五千张图片和两千多段视频,作者的结论是,最先进的基线模型在最难的任务上表现不佳,即使经过监督微调和强化学习,成绩仍然不高。也有工作尝试通过强化学习,让模型主动、迭代地挑选帧,而不是被动看完整段视频,并宣称用更少的帧取得了更好的结果,这属于作者自己的评测结论,还有待更广泛的验证。
把这几项放在一起看,会发现共同点:难的地方不在“认出这是一次杀球”,而在杀球的细节,击球高度、拍面、落点,以及它与对手位置的关系。这恰恰对应“人与器材互动”的部分。
观察四:高尔夫说明了“遮挡”这个老问题为什么更棘手
上面几条大多在球拍类运动里。高尔夫的情况略有不同:球杆细长,挥杆过程中身体和杆互相遮挡,姿态估计常常在上杆顶点和下杆阶段出错。公开资料显示,有研究指出普通姿态模型会被高尔夫挥杆里少见的姿势和自遮挡误导,并建立了同时含球手与球杆姿态的小型数据集;更早的GolfDB则把挥杆划分为八个事件,从站位到收杆,用于挥杆事件定位。这些工作说明,“人+杆”的联合理解需要专门数据,而不是把一个通用姿态模型直接搬过来。这与《一部手机能不能同时教篮球、网球、羽毛球和高尔夫?od体育多模态AI正在解决运动项目差异》里的判断一致。
观察五:从“识别”走向“给出反馈”,互动信息成了原材料
还有一条线把上面几条连了起来。公开资料显示,2025年的CVPR上有一项名为ExpertAF的工作,输入是一段视频和对应的三维人体姿态,输出是自由形式的专家式评论,说明哪里做得好、哪里可以改进,并附带一段示范动作;它的弱监督训练数据来自带有专家评论的大型多视角数据集,再借助大语言模型整理成训练样本。作者报告,在指标和人类偏好评估上都优于较强的视觉语言模型基线。2026年初的一项攀岩案例研究,也专门为体育反馈提出“具体性”和“可操作性”两个评价维度,理由是为机器翻译设计的文本指标看不出一句反馈到底有没有用。
这一条对“人与器材互动”的意义在于:反馈要说得具体,就必须有具体的原材料。“拍面偏开”“杆头过早释放”这类句子,背后都是器材相对身体的状态。如果感知层只输出人体关键点,语言层再流畅,也只能说些笼统的话。因此,互动信息的质量,很大程度上决定了后面“AI教练”能不能说到点子上,这一点在od体育官网关于可解释教练的专题里有更细的讨论。
为什么说这是“转向”,而不只是又一个研究热点
转向的证据在于评价对象变了。过去的基准问“这个人的关键点准不准”,现在的基准问“球拍和球的关系对不对”“这个位置离网多远”“击球时机是否合理”。评价对象的改变,决定了训练数据、标注方式和模型结构都要跟着变:需要器材姿态标注,需要度量空间,需要按击球事件切片的时间序列。
但同样需要保持怀疑。第一,这些成果多数是学术基准上的结果,数据往往来自广播视频或特定采集环境,与用户用手机在球场边拍的视频差别很大。第二,不少工作集中在乒乓球、羽毛球这类便于采集的项目,篮球的多人空间与高尔夫的球杆并不在同一层次。第三,“基准上更好”与“对训练有用”之间有一段距离,用户需要的是可解释、可操作的反馈,而不是榜单上的一个点。
od体育的观察:这对产品意味着什么
对od体育来说,这些公开进展带来的不是“可以宣称什么”,而是几条更实际的取向。
- 器材要成为一等公民。球拍拍面、球杆杆头不是姿态模型的附属输出,需要单独追踪、单独校验置信度。
- 融合要有结构。不同信号在不同阶段的可信度不同,融合应当按击球阶段来做,而不是一次性拼接。
- 空间要有尺度。球场线、球网、地面等固定物,是把像素变成距离的依据,也是拍摄指引强调“把球场拍进去”的原因。
- 诚实标注不确定。器材被遮挡时,输出应当降级,而不是编一个数。
需要强调的是,以上是od体育对公开趋势的解读和当前的设计思路,不表示某个具体指标已经达到什么水平,也不涉及与任何研究团队或机构的合作。更进一步的一条线索,是高速小球本身为什么仍然难追踪,这一点在另一篇观察《高速小球为什么仍然难追踪?od体育观察体育计算机视觉的新难题》里单独展开。