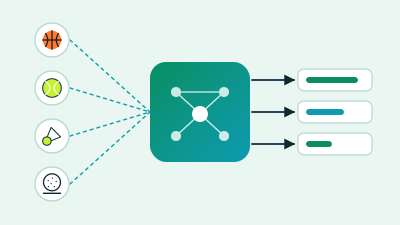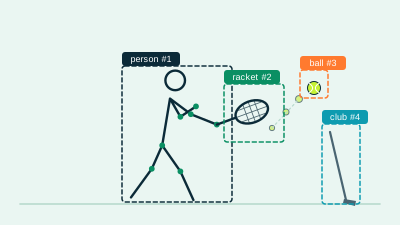
先说结论:od体育不把体育分析交给单一模型,不是因为喜欢复杂,而是因为每一种模型天生只擅长回答一类问题。姿态模型回答“身体各点在哪”,目标检测回答“画面里有什么、在哪”,追踪回答“这一帧的它是不是上一帧的它”,时间序列模型回答“这些位置随时间意味着什么动作”,语言模型回答“怎样把结果讲给人听”。把五件事塞进一个端到端网络,训练数据、可解释性和排查问题的成本都会急剧上升。下面用一段模拟的训练视频,按顺序走一遍。
第0站:视频本身,决定了后面所有站的上限
进入模型之前,视频要先过一道基础检查:分辨率是否足够看清目标,帧率是否够高,画面是否抖动,主体是否完整入镜。这不是模型,却是最重要的一站。高速动作下,30帧每秒的视频里一次挥拍只有十几帧,60帧每秒能多一倍时间分辨率;逆光、机位太远会让球和球拍变成几个像素。后面每个模型都是“垃圾进,垃圾出”,所以od体育的设计取向,是在拍摄阶段就尽量提示机位、光线和入镜范围,而不是等分析失败以后再提醒。同一个动作用30帧和60帧拍出来,能得到的信息并不相同;同一个人站在离镜头三米和十米的位置,姿态点的可靠程度也不一样。
第1站:姿态估计,只负责身体
姿态估计模型输入一帧图像或一个人的裁剪区域,输出关键点坐标和每点的置信度。公开的轻量方案如 RTMPose 报告过在手机芯片上的实时速度,MediaPipe 一类方案则更偏向移动端和浏览器;精度更高的 ViTPose 一类模型运算量更大。选哪一种,取决于算力与精度的取舍,而不是谁“更先进”。
它做不到的事:不知道球拍在哪,不知道球在哪,不知道这一帧是发球还是回球,对深度方向的判断也很弱。它看到的是一个高度概括的火柴人。
第2站:目标检测,补上身体之外的东西
目标检测模型给出球、球拍、球杆、篮筐、场地线等的位置框或关键点。它需要的训练数据和姿态模型完全不同:球拍在不同角度、不同光线下的样子,小球的样子,甚至同一个球在快速运动中的拖影样子,都要有标注。这一站还有一个专门的分支,就是小球追踪:网络使用连续几帧,靠“球在前后帧里移动”找球,能补足单帧检测在小目标上的缺陷。
它做不到的事:只认“类别”。它知道这里有一个球拍,不知道这个球拍属于谁;它给出每帧独立的框,没有“同一个”的概念。
第3站:追踪,给一切加上身份
追踪模块读入前两站的所有输出,为每个人、每件器材分配稳定的编号,用位置、速度、外观特征做匹配。公开的多目标追踪方法(如 ByteTrack)强调即使检测分数低、被遮挡,也不要轻易放弃这条轨迹。追踪之后,“球拍属于谁”“球被谁碰过”才有意义。
它的典型错误是编号交换和轨迹断裂。多人项目里编号交换几乎是最常见的问题,个人训练里更多是球被遮挡后重新出现时被当成另一个球。
第4站:时间序列模型,把散点变成动作
到这一站,输入已经是一组带编号的时间序列:每个关键点、每件器材、球的位置随时间变化。时间序列模型(可以是传统的信号处理加规则,也可以是学习得到的序列模型)做的是:平滑和补洞;检测击球、落地、离手等关键事件;把动作切成阶段;计算阶段内的指标,如网球发球从抛球到击球的时间、羽毛球回位用了多少帧、高尔夫上杆和下杆的时间比。
这一站也是项目差异最集中的地方。同样一串关键点,网球模型会寻找“击球点”,高尔夫模型会寻找“顶点”,篮球模型会寻找“掩护发生的时刻”。这些项目知识大多写进时间层的规则和标签里,而不是姿态模型里。
第5站:语言模型,负责把结果讲清楚
语言模型的位置常常被高估。它不适合直接“看视频给出结论”:公开的体育理解基准,如面向多项运动的 SPORTU、强调规则与视觉证据的 SportR、面向羽毛球的 FineBadminton,都显示通用多模态大模型在细粒度体育推理上仍有明显差距。所以od体育的思路是让语言模型读结构化的测量结果,例如“击球点相对前脚偏后、髋转动早于拍头加速”,再把它翻译成球员能理解的话,并按用户的训练目标和历史记录组织建议。
这样做的另一个好处是可追溯:如果建议看起来不对,可以回头查是哪一站的数据出了错,而不是面对一个黑盒。对“建议为什么这样说”的更细讨论,见od体育官网为什么把篮球、网球、羽毛球和高尔夫放进同一个AI运动分析体系?中对解释性的部分。
为什么不干脆训练一个端到端的大模型
这个问题值得单独回答,因为它看上去最“现代”。端到端的视频大模型确实能在通用视频问答里表现出令人意外的能力,也有研究团队在单一运动里做统一的视觉基础模型,例如把足球中的检测、追踪、事件分类和解说放在同一个框架中预训练。但把它推到四项运动、手机端、可解释的训练建议,会遇到三个现实问题。
- 数据。端到端训练需要大量“视频加专业标注”的配对数据,而运动技术的标注,如击球点是否偏晚、杆头路径是否内侧切入,需要有经验的人逐段判断,成本远高于给关键点画点。
- 算力。视频大模型通常需要服务器级算力;手机上的实时或近实时分析,更适合体积小、可以分别优化的专用模型。
- 可排错。建议不对时,分层系统可以顺着每一站往回查;端到端模型只能整体重训。
这不是说大模型没有用。od体育更倾向的做法,是让大模型出现在最合适的位置,也就是理解用户的训练目标、组织解释语言、回答追问,而把测量交给专用模块。
错误怎样一层层传递
假设一段网球正手视频里,球拍在击球瞬间因运动模糊,被检测模块错误地估到了拍框位置。追踪模块没有异常,因为拍头位置只是“晚了几帧”。时间序列模块据此把击球时刻推迟了两帧,于是算出的击球点比真实位置更靠前。语言模型忠实地写出“击球点位置很理想”。这条链上没有任何一个模型出了明显错误,但结论是错的。
od体育的设计取向是在每一站都保留置信度,并在时间层里做一致性检查:如果拍头速度峰值和球的速度突变不在同一帧附近,就说明两路输入互相矛盾,要降低结论的可信度,而不是各自照单全收。这也是“多模型”比“一个大模型”更容易治理的地方:每一站都可以单独设测试、单独替换。
什么时候该加入更多输入
有些问题靠视频本身解决不了。三维姿态从单机位恢复,天生有深度歧义;球速和旋转需要雷达;发力和加速度需要穿戴式惯性传感器。公开研究显示,惯性传感器与视频融合是提升动作捕捉可靠性的常见路线,但也意味着用户要佩戴额外设备。od体育当前主要依靠手机视频,遇到需要额外设备才能回答的问题,会明确说明“这个量目前测不了”,而不是用一个估计值蒙混过去。如果你想了解这些思路背后的整体体系,可以回到一部手机能不能同时教篮球、网球、羽毛球和高尔夫?od体育多模态AI正在解决运动项目差异,或者继续读关于物体清单的体育大模型到底需要认识多少种“物体”?od体育AI同时追踪人、篮球、网球、球拍和球杆。